Gratuito até a entrega do resultado
Não colocar pagamento entre o processamento e a entrega. A gratuidade não termina justamente quando o usuário precisa baixar aquilo que produziu.
Problema concreto → solução funcional
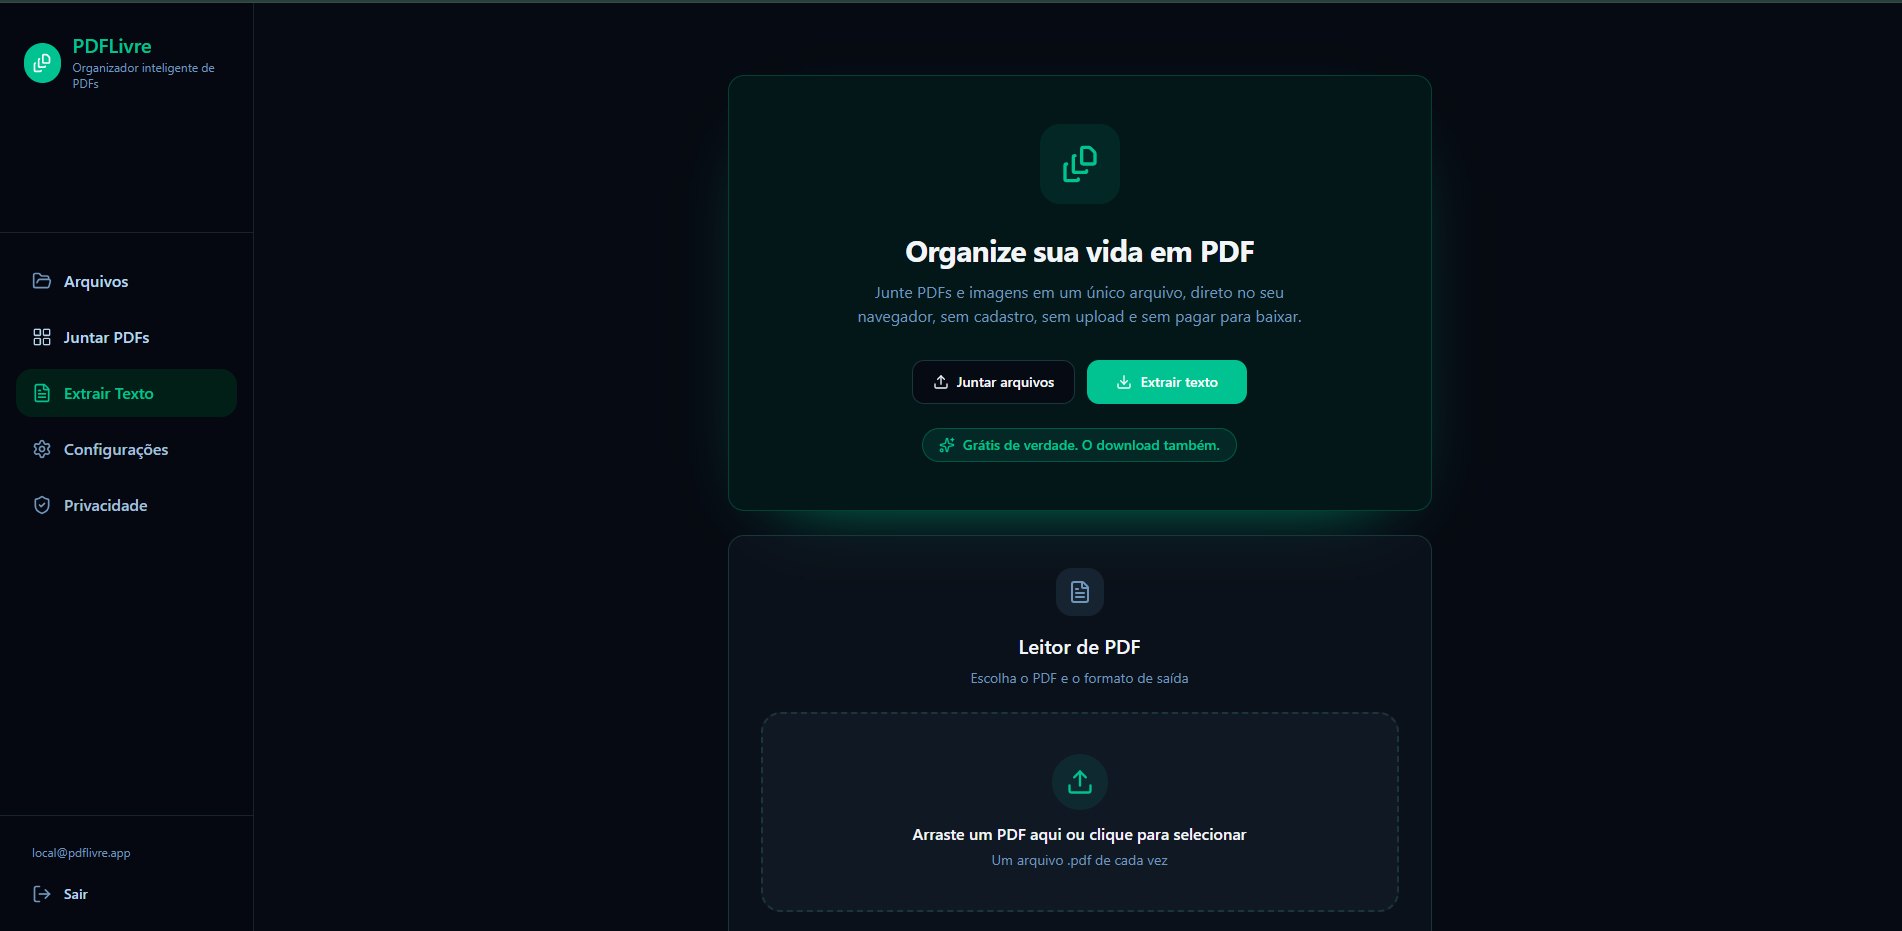
Aplicação web para operações simples com PDF diretamente no navegador: juntar PDFs e imagens em um único arquivo e extrair a camada textual de um PDF para TXT ou Markdown. Sem conta, sem cadastro e sem envio dos documentos para um servidor de processamento.
Como surgiu
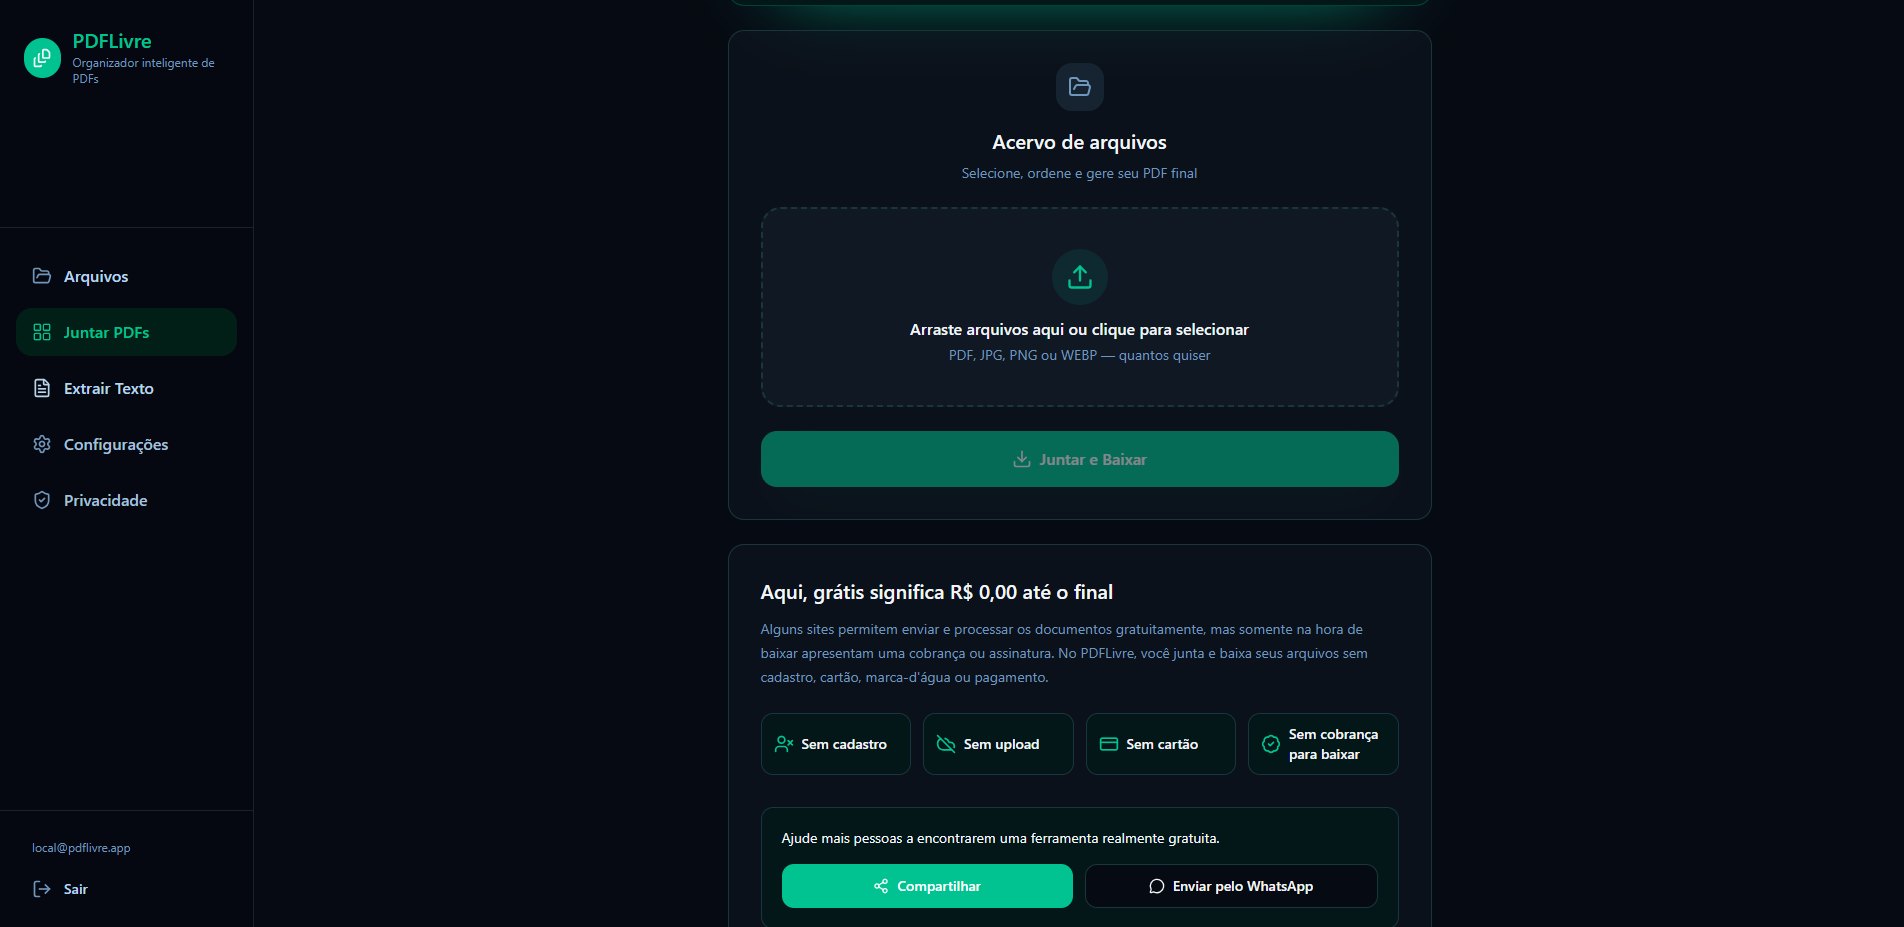
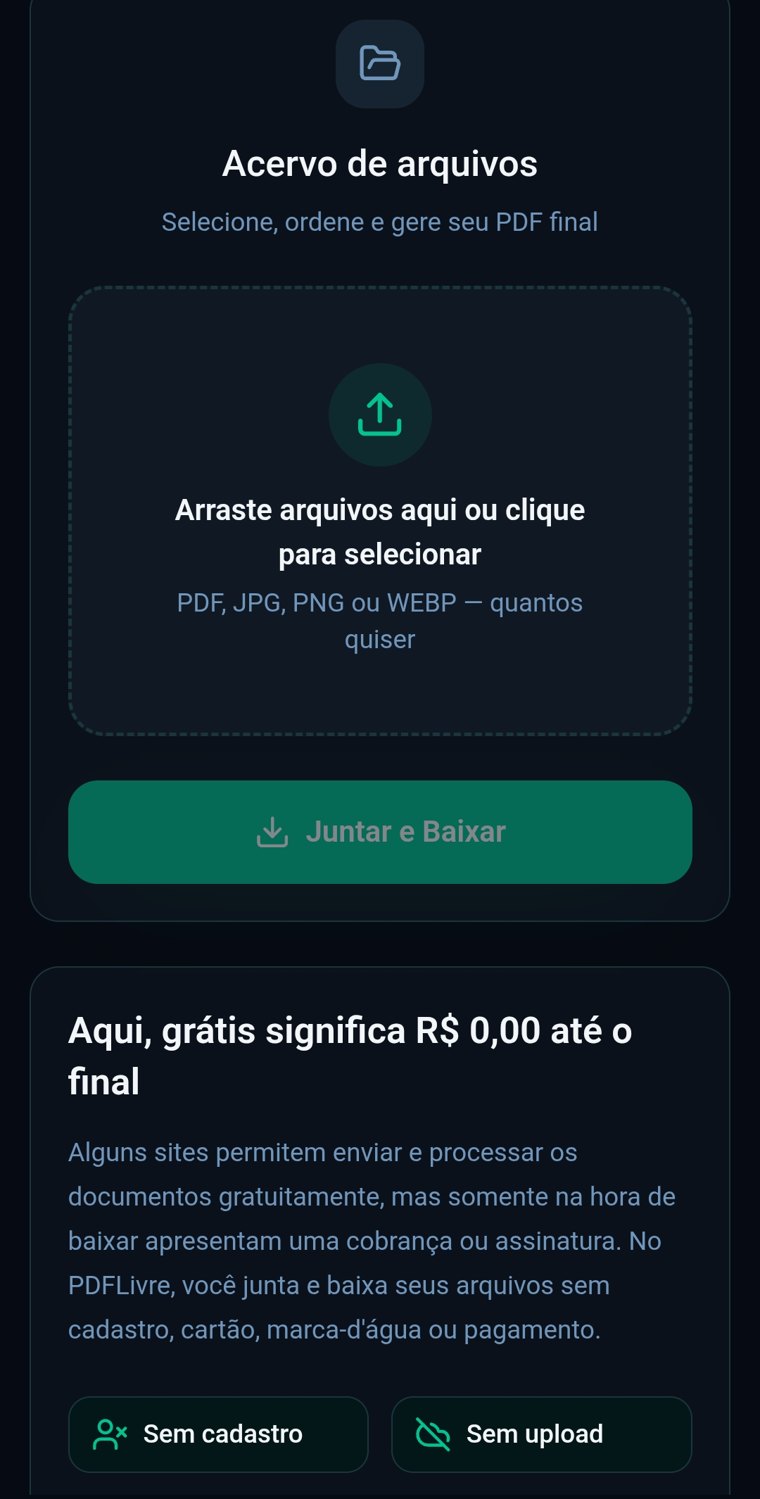
A necessidade era simples: reunir vários documentos em um único PDF. Diversos serviços encontrados se apresentavam como gratuitos, mas o problema aparecia no final — depois de selecionar, organizar e processar tudo, alguns liberavam o download apenas mediante pagamento ou assinatura.
Essa experiência levou a duas decisões: não criar um bloqueio comercial escondido no final do processo e não criar infraestrutura de processamento de documentos que a operação não precisa.
Existe uma opção de doação voluntária por PIX, completamente independente das funções de PDF. Não doar não reduz, bloqueia ou altera o funcionamento da ferramenta.
Função 1 — Juntar
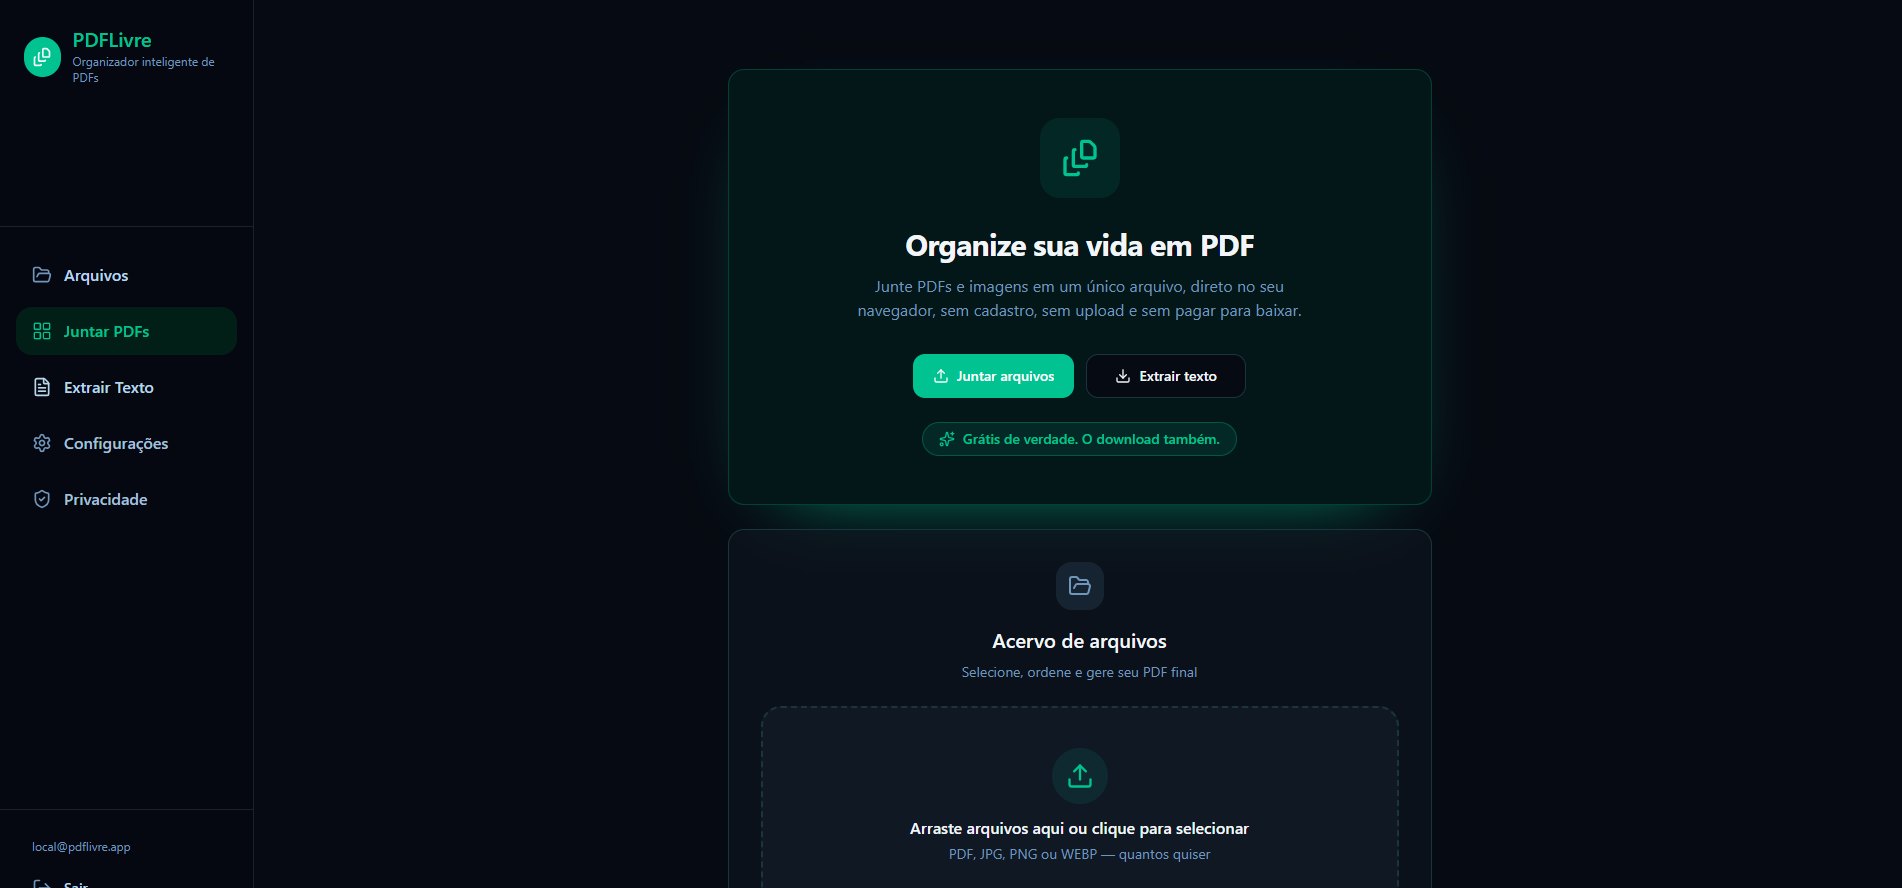
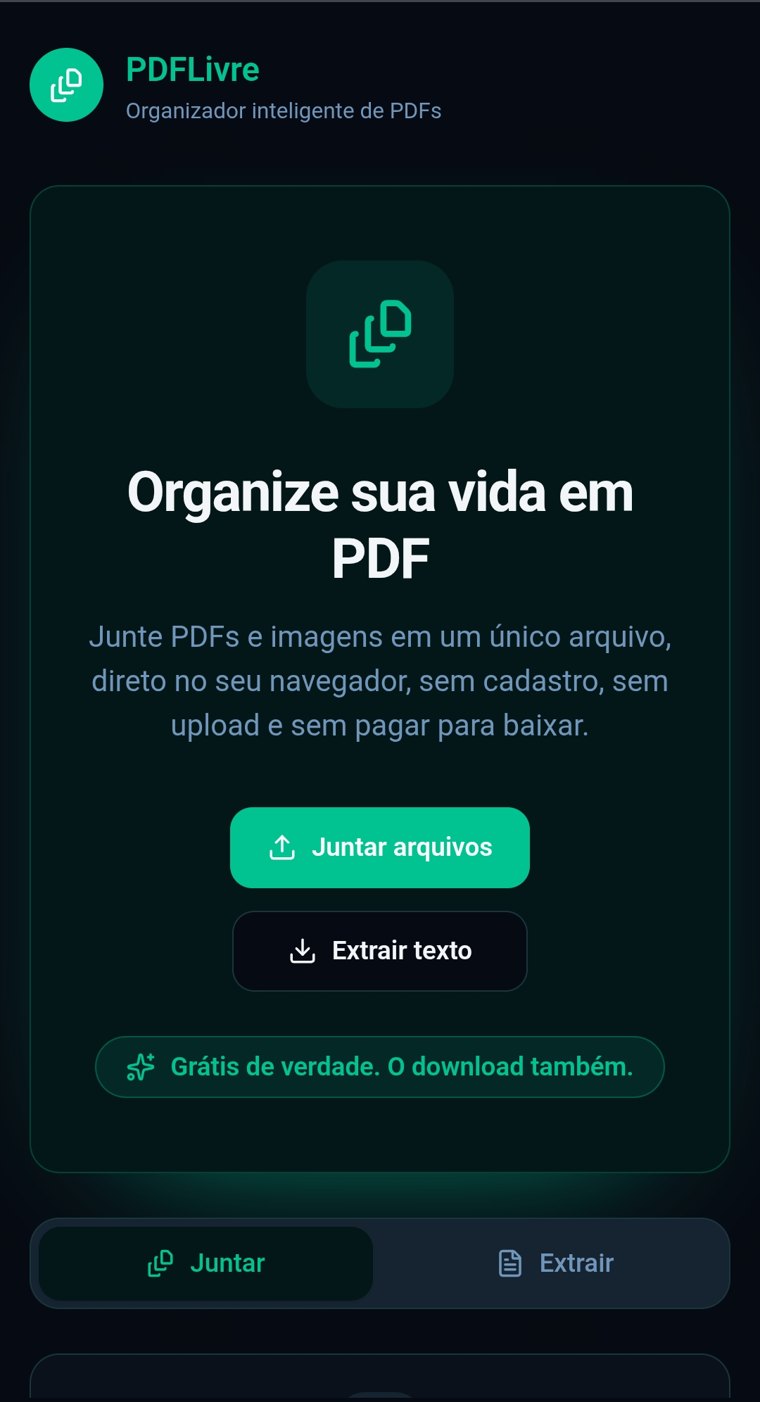
São aceitos PDF, JPEG, PNG e WEBP. Depois de selecionados, os arquivos aparecem em uma lista: é possível adicionar novos itens, alterar a ordem, remover e limpar a seleção. A ordem da lista determina a sequência do PDF resultante.
PDFs têm suas páginas copiadas para o novo documento e imagens são transformadas em páginas. No caso de WEBP, a imagem é convertida localmente para uma representação compatível antes de ser incorporada. Concluída a operação, o navegador gera pdf-livre-juntado.pdf e inicia o download.
Função 2 — Extrair texto
A função trabalha com um PDF por vez. O usuário seleciona o arquivo e escolhe TXT ou Markdown. O PdfLivre percorre as páginas e recupera a camada textual do documento; havendo texto, o resultado é transformado em arquivo e baixado, usando o nome original como base.
A extração não utiliza OCR. Um PDF formado apenas por imagens digitalizadas pode não possuir camada textual para extrair. Quando nada é encontrado, a aplicação informa a situação em vez de gerar um arquivo vazio como se a operação tivesse funcionado. Extrair texto existente em um PDF não é o mesmo que reconhecer texto dentro de uma imagem.
Destaque de engenharia
As duas operações acontecem no navegador. O arquivo entra pelo dispositivo, é processado em memória e o resultado volta para o próprio dispositivo. As bibliotecas necessárias são executadas no cliente.
Na junção
Na extração
A implementação atual não cria upload de PDFs para processamento, banco de documentos, Storage, histórico central de operações, conta de usuário nem serviço de processamento de PDF no servidor. A privacidade não depende apenas de uma mensagem na interface: ela decorre do desenho do fluxo.
O custo computacional acompanha o usuário. Não existe processamento do documento no servidor, mas a capacidade depende do navegador e do dispositivo. Também não há IA no fluxo: as duas funções são determinísticas, apoiadas em bibliotecas de manipulação de PDF, em um parser e em uma regra local simples para produzir TXT ou Markdown.
Ausência de limite artificial programado não deve ser interpretada como capacidade fisicamente ilimitada.
Decisões
Não colocar pagamento entre o processamento e a entrega. A gratuidade não termina justamente quando o usuário precisa baixar aquilo que produziu.
Juntar arquivos e ler a camada textual podem ser feitos no navegador. O documento não precisa ir a um servidor de processamento para que a função principal aconteça.
Backend, upload, Storage, banco e histórico seriam tecnicamente possíveis. A arquitetura permanece proporcional ao problema atual, com menos componentes e menor responsabilidade sobre documentos de terceiros.
O usuário chega, realiza a tarefa e sai sem criar uma identidade apenas para processar um documento.
A extração fica limitada ao texto efetivamente disponível no PDF. O limite é explicitado em vez de introduzir outra infraestrutura fora do escopo atual.
O resultado é gerado como arquivo temporário no navegador e baixado. Não é preciso manter um repositório dos resultados produzidos.
Limites atuais
Não é uma suíte completa de edição de PDF. A reordenação disponível organiza os arquivos de entrada, não páginas individuais dentro de um PDF. Não foram implementadas como operações principais:
Também não existem hoje pré-visualização do PDF final, prévia ou edição do texto extraído, indicador granular de progresso, cancelamento do processamento iniciado, validação avançada de PDFs protegidos ou malformados e bateria automatizada de testes cobrindo todos os tipos e tamanhos de documento.
Na extração, estruturas complexas como colunas, tabelas e formatação podem não ser reproduzidas fielmente: o objetivo é recuperar a camada textual disponível. A saída Markdown utiliza uma transformação simples e não reconstrói semanticamente toda a estrutura original.
Demonstração
Em breve
Se este trabalho despertou seu interesse e você quiser conhecer a aplicação com mais detalhes, entre em contato comigo pelo WhatsApp.
Conversar pelo WhatsApp